Воспроизводимый context evidence · MIT + CC BY 4.0
Fixture для context assembly manifest
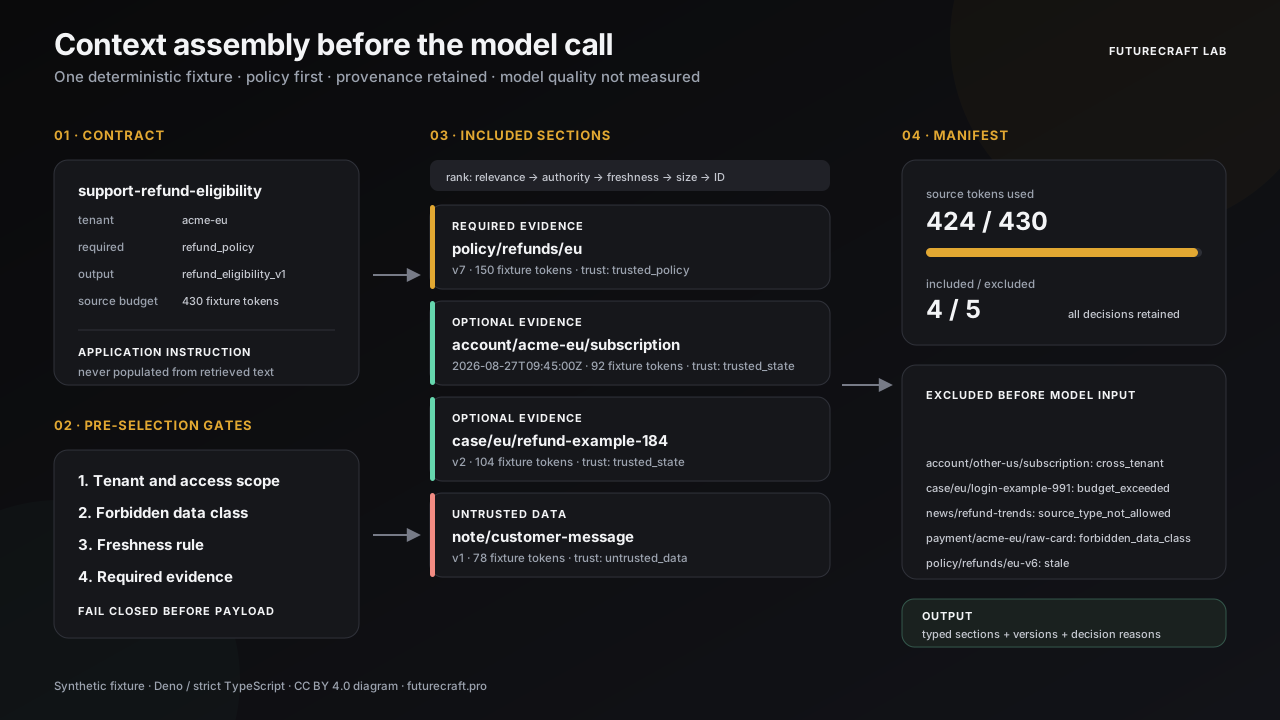
Посмотрите, как один фиксированный task фильтрует девять синтетических источников по tenant, scope, data class и freshness до ranking и token budget. В bundle входят strict TypeScript, шестнадцать tests, проверенный manifest и SVG-диаграмма.
Файлы
Policy до ranking
Cross-tenant, запрещённые, недоступные и устаревшие кандидаты отсеиваются до того, как relevance или authority повлияют на выбор.
Fail-closed evidence
Если обязательный источник отсутствует, устарел или не помещается в budget, сборка останавливается до появления model payload.
Проверяемые решения
У включённых и исключённых источников сохраняются версии, trust labels, token counts и машиночитаемые причины решения.
Проверенные границы
Шестнадцать tests проверяют required-source failures, freshness, tenant и scope isolation, запрещённые данные, distractor overload, budget, prompt injection, детерминированный output, сохранённый evidence и SVG. Happy path выбрал 424 из 430 заданных source tokens.