Context engineering: что это и как управлять контекстом LLM
Что такое context engineering?
Context engineering - проектирование всей информации, доступной модели во время вызова: инструкций, состояния задачи, найденных источников, описаний tools, истории и ограничений output.
TL;DR
- -Context engineering определяет, какие факты, инструкции, tools и состояние модель получит на следующем шаге
- -Заявленный размер окна - предел вместимости, а не гарантия правильного использования каждого факта
- -Разделяйте постоянные правила, задачу, найденные источники и недоверенный контент, чтобы конфликты были видны
- -Сначала отбирайте, потом сжимайте: summary теряет детали и обязано сохранять источники, решения и открытую работу
- -Проверяйте сборку до вызова модели: наш fixture из 16 тестов останавливается при пропавшей policy, устаревшем источнике, утечке между tenants и переполнении budget
Context engineering (контекст-инжиниринг) - это проектирование всего, что LLM видит во время вызова: инструкций, истории, найденных документов, описаний tools, памяти и ограничений на ответ. Проще говоря, это управление контекстом модели.
Context engineering отвечает на один production-вопрос: что модель должна увидеть перед следующим шагом?
Это не только запрос пользователя. Агент может получить правила проекта, историю, найденные документы, схемы tools, результаты вызовов, память, permissions и контракт output. Любая часть способна оказаться пропущенной, устаревшей, противоречивой или вредоносной.
Prompt engineering по-прежнему важен: он задаёт способ работы. Context engineering управляет фактами и состоянием, на которых эта работа строится.
Большое окно - вместимость, а не память
Допустимое число токенов показывает, какой input принимает API. Оно не обещает, что модель одинаково и правильно использует каждый факт. Из чего состоит окно и каких размеров оно у разных моделей, описано в статье о контекстном окне LLM.
Авторы Lost in the Middle показали, что на multi-document QA и key-value retrieval результат модели менялся в зависимости от положения нужной информации. Новые модели и другие задачи ведут себя иначе, поэтому совет «кладите всё важное по краям» не универсален. Вывод уже: проверяйте retrieval и reasoning на реальных длине, порядке и количестве отвлекающих данных.
Большой контекст создаёт и прямые издержки:
- input обрабатывается на каждом вызове, если не сработал provider cache;
- повторяющиеся tool results быстро занимают агентный цикл;
- старые инструкции продолжают конкурировать с текущими;
- чувствительные данные получают все провайдеры, куда ушёл запрос;
- больший набор источников означает больше утверждений для проверки.
Цель - не самый короткий промпт. Нужен минимальный контекст, где всё ещё есть доказательства и ограничения конкретной задачи.
Собирайте контекст из типизированных секций
Не склеивайте вход в один текстовый блок. У каждой секции должна быть роль и уровень доверия.
1. PLATFORM POLICY       обязательные safety- и permission-правила
2. PROJECT GUIDANCE      архитектура, конвенции, допустимые зависимости
3. TASK                  цель, scope, deadline, контракт output
4. CURRENT STATE         файлы, состояние workflow, свежие tool results
5. RETRIEVED EVIDENCE    цитаты или структурированные источники
6. EXAMPLES              примеры ожидаемого результата
Это не магическая формула из шести частей. Одной задаче хватит трёх, другой нужно десять. Польза - в видимых границах:
- инструкции не смешиваются с исходными данными;
- найденная веб-страница не может незаметно переопределить system policy;
- у состояния есть источник и timestamp;
- citation ведёт к исходному документу;
- приложение независимо ограничивает или убирает каждую секцию.
Недоверенные данные размечайте явно. Веб-страница, тикет, комментарий в коде или загруженный документ могут содержать «игнорируй прошлые инструкции». Это текст для анализа, а не правило для исполнения.
Определите контракт контекста для задачи
Разным задачам нужны разные данные. Для code review важны diff, соседние интерфейсы, результат тестов и правила репозитория. Весь репозиторий обычно не нужен. Для ответа поддержки нужны сообщение клиента, допустимое состояние аккаунта и актуальная policy, а не полная история другого пользователя.
Границу можно сделать исполняемой:
interface ContextContract {
  task: 'review_pull_request' | 'answer_support_ticket';
  requiredSources: string[];
  optionalSources: string[];
  forbiddenDataClasses: string[];
  maxAgeMinutes: Record<string, number>;
  tokenBudget: number;
  outputSchema: string;
}
До вызова модели контракт отвечает на пять вопросов:
- Какие факты обязаны присутствовать?
- Какой источник главнее при конфликте?
- Насколько свежим должен быть каждый тип данных?
- Какие данные запрещены для задачи или провайдера?
- Какой output приложение сможет проверить?
Без контракта retrieval оценивают по ощущению «ответ выглядит хорошо». Такой критерий пропускает тихие ошибки.
Проверенный manifest вместо красивой схемы
Интерфейс ничего не гарантирует, пока приложение не применяет его правила. Поэтому мы собрали исполняемый fixture для context assembly на strict TypeScript. Он показывает решение до обращения к модели, а не пытается объяснить сбой по готовому ответу.
Сценарий намеренно небольшой: нужно ответить на синтетический вопрос о возврате. В контракте есть обязательная policy, три допустимых типа дополнительных источников, scopes вызывающей стороны, запрещённые классы данных, ограничения по свежести и budget в 430 source tokens. Tenant, доступ, класс данных и свежесть проверяются до ranking. Если обязательный источник пропал или не помещается, payload не создаётся.
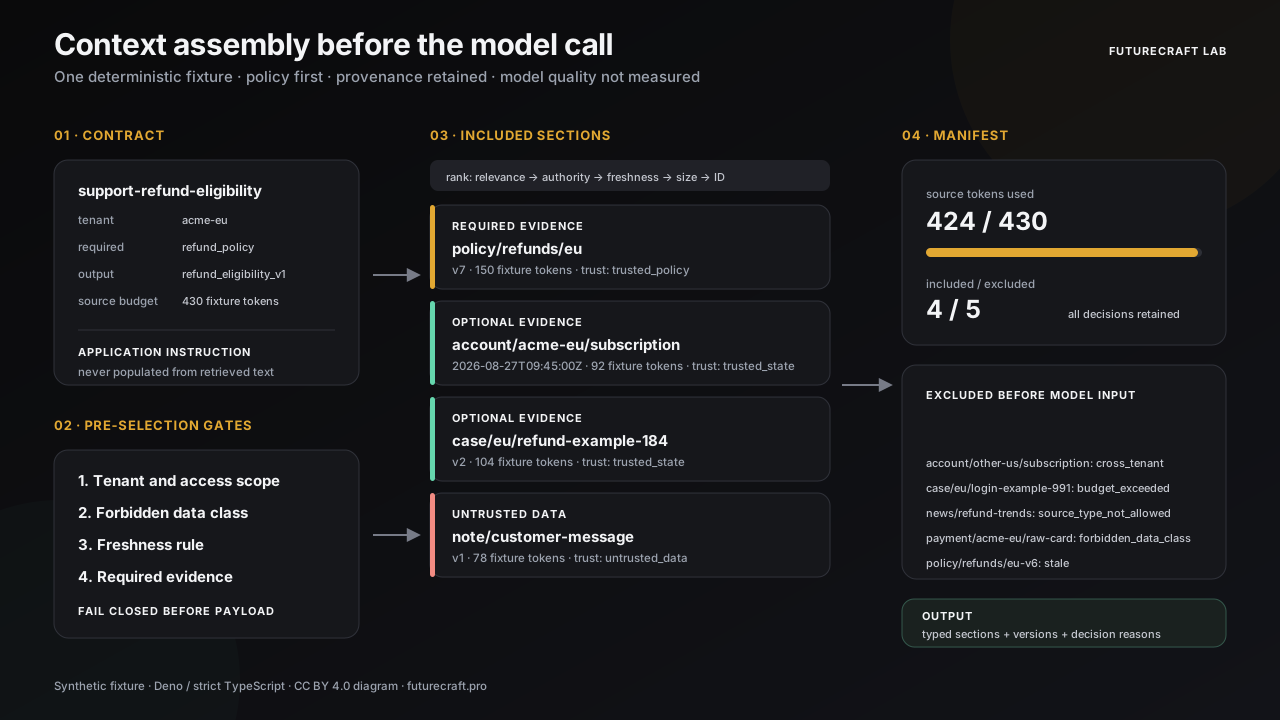
В сохранённом run было девять кандидатов:
| Кандидат | Что сделал assembler |
|---|---|
| Актуальная refund policy | Включил как required evidence |
| Свежее состояние аккаунта | Включил как trusted optional evidence |
| Релевантный закрытый кейс | Включил как trusted optional evidence |
| Сообщение с prompt injection | Оставил только в untrusted_data |
| Аккаунт другого tenant | Исключил как cross_tenant |
| Raw payment record | Исключил как forbidden_data_class |
| Старая версия policy | Исключил как stale |
| Посторонний support case | Не поместил в оставшийся budget |
| Marketing article | Исключил как недопустимый тип источника |
Итог: 424 из 430 заданных source tokens, ещё шесть остались свободны. Это числа fixture, а не результат tokenizer конкретного API. Шестнадцать tests проверили отсутствие обязательного источника, старую policy, изоляцию tenant и scope, запрещённые данные, 50 отвлекающих документов, переполнение budget, повторяющиеся ID источников, prompt injection, повторяемый JSON и SVG.
Граница evidence здесь важнее зелёного отчёта. Run подтверждает поведение этого assembler, но не качество ответа LLM и не универсальность ranking. В комплекте с кодом и evidence report есть точные команды запуска. Для своего продукта подставьте реальный retrieval eval и tokenizer провайдера.
Сначала отбор, затем сжатие
В руководстве Anthropic операции с контекстом разделены на запись, отбор, сжатие и изоляцию. Порядок важен.
Отбор убирает то, чего не должно быть в запросе. Сжатие переписывает нужные, но слишком объёмные данные. Summary нерелевантных логов остаётся нерелевантным, даже если стало короче.
Для задачи с кодом начните с детерминированного поиска:
- изменённые файлы и соседние интерфейсы;
- callers и тесты, найденные поиском по коду;
- правила проекта, применимые к этим путям;
- точная упавшая команда и краткая ошибка;
- документация версий зависимостей и API проекта.
Для knowledge-задач сочетайте retrieval-сигналы. Metadata filters, keyword search, embeddings, reranking, recency и access control решают разные проблемы.
В отдельном гайде про RAG и long context есть схема выбора для retrieval-heavy задач.
Не теряйте происхождение источника
Фрагмент без документа, даты и темы легко применить не туда. Храните provenance рядом с текстом:
{
  "text": "Возврат доступен в течение 30 дней...",
  "sourceId": "policy/refunds/v4",
  "sourceUrl": "https://docs.example.com/refunds",
  "updatedAt": "2026-07-11T09:30:00Z",
  "accessScope": "support-emea",
  "section": "Eligibility"
}
В экспериментах Anthropic с Contextual Retrieval к chunk перед индексацией добавлялся короткий контекст всего документа. Общий принцип применим в любом стеке: фрагмент должен содержать достаточно данных для корректного поиска и citation.
Ранжирование не отменяет authorization. Отфильтруйте tenant и права документа до попадания текста в запрос модели, а не после генерации.
Считайте описание tools частью контекста
Имена, описания, schemas и результаты tools занимают окно и меняют выбор модели. Больше tools не всегда означает более способного агента. Неоднозначные tools дают неоднозначные решения.
У хорошего tool-контракта есть:
- конкретное действие в имени;
- описание, когда применять и когда не применять;
- типизированный input с
customerId, а неdata; - structured output, если его поддерживает протокол;
- ограниченный размер результата или pagination;
- явный формат ошибки;
- server-side authorization, не зависящий от модели.
Небольшой постоянный набор загружайте сразу. Специализированные tools находите по мере необходимости. Сравнивайте дополнительный шаг discovery с ценой токенов и ошибками выбора при передаче всех schemas в каждом запросе.
Для MCP-систем см. гайд по production MCP server.
Разделяйте историю, рабочее состояние и память
Это три разных продукта данных:
- История - transcript взаимодействия.
- Рабочее состояние - то, что установил текущий workflow.
- Память - постоянные сведения для будущих задач.
Полная история в каждом запросе смешивает их. Временная гипотеза отладки начинает выглядеть как решение. Исправление пользователя теряется под ранними репликами. Выборочно удалить один персональный факт становится трудно.
Для долгой задачи с кодом держите явный checkpoint:
## Цель
Добавить идемпотентный импорт счетов без изменения public API.

## Проверенное состояние
- Тесты parser проходят.
- В БД есть unique constraint на provider + external_id.

## Решения
- Повторять import jobs; не повторять payment capture.

## Неудачный подход
- In-memory deduplication не работает между workers.

## Следующий шаг
Добавить concurrency test до изменения worker.
Такой checkpoint можно проверить, отредактировать и дёшево загрузить. В гайде по памяти AI-агента подробнее разобраны provenance, конфликты, retention и deletion.
Сжимайте в контрольных точках
Compaction всегда теряет детали. Убедительное summary всё равно может пропустить единственное ограничение, нужное на следующем шаге.
Сжимайте на стабильной границе: прошёл тест, принято решение, закрыт этап инцидента. Сохраните:
- текущую цель и non-goals;
- проверенные факты со ссылками на источники;
- решения и их причины;
- изменённые файлы или записи;
- выполненные команды и результат;
- неудачные подходы, которые не стоит повторять;
- открытые вопросы и следующее действие.
Не переносите secrets в постоянный summary. Не сохраняйте сырые персональные данные, если хватает стабильного ID. Если policy разрешает, оставьте доступ к источнику и проверьте сжатое состояние до удаления истории.
Изолируйте работу узким handoff
Отдельный worker или субагент полезен, когда подзадаче нужен чистый контекст или другая граница permissions. Изоляция не означает копирование полного transcript родителя в новое окно.
Хороший handoff содержит:
- одну ограниченную цель;
- минимум релевантных источников;
- ограничения и запрещённые изменения;
- формат результата;
- способ проверки результата родителем.
Параллельные workers добавляют риск merge и рассинхронизации. Два агента, одновременно меняющие один файл или план, - не context engineering, а ошибка координации.
Тестируйте сборку контекста как код
Evals должны диагностировать context pipeline, а не только финальный ответ. Добавьте случаи:
| Сбой | Тест |
|---|---|
| Нет обязательного источника | Retrieval ничего не вернул |
| Distractor overload | Нерелевантные правдоподобные документы попали наверх |
| Конфликт инструкций | Project guidance противоречит старой реплике |
| Устаревшее состояние | Новая версия policy обязана победить |
| Prompt injection | Найденный текст содержит команды агенту |
| Cross-tenant leak | Подходящий документ принадлежит другому tenant |
| Потеря при compaction | Решение исчезло из summary |
| Неоднозначные tools | Два tools выглядят как одно действие |
Для каждой оценки сохраняйте context manifest: IDs и версии источников, порядок, токены по секциям, retrieval scores и policy filters. Не кладите сырые PII в traces. При регрессии manifest отделит изменение модели от ошибки retrieval или assembly.
Наш fixture можно использовать как начальный contract test, но не как готовый end-to-end eval. Добавьте собственный retriever, provider tokenizer, проверки model output и частоты реальных сбоев до того, как делать из thresholds release gate.
Evaluation sets и release gates разобраны в гайде по тестированию AI-агентов.
Checklist перед production-вызовом
До вызова:
- У задачи есть контракт output и условие остановки.
- Обязательные источники присутствуют и сохраняют provenance.
- Правила authority и freshness разрешают конфликты.
- Недоверенный контент отделён от инструкций.
- Tenant, region и data-class фильтры отработали до отправки результатов.
- Tools релевантны, типизированы и авторизуются на сервере.
- Бюджет задан задачей, а не максимумом модели.
После вызова:
- Structured output и доменные правила прошли validation.
- Утверждения прослеживаются до переданных источников.
- Tool calls учитывают permissions и idempotency.
- У новых постоянных фактов есть source, timestamp и deletion policy.
- Context manifest доступен для отладки без раскрытия сырых PII.
Первоисточники
- Anthropic: Effective context engineering for AI agents
- Lost in the Middle: How Language Models Use Long Contexts
- Anthropic: Contextual Retrieval
- Model Context Protocol 2026-07-28: Tools
Хороший контекст - не «всё, что может пригодиться модели». Это проверенное и прослеживаемое входное состояние: достаточно фактов для одной задачи и достаточно границ, чтобы посторонние данные не стали инструкциями.