AI Lead Scoring: как проверить модель до запуска
Что такое validation-first AI lead scoring?
Validation-first AI lead scoring — система, в которой модель предлагает оценки fit и intent со ссылками на исходные данные, обычный код отбрасывает некорректные записи и утечку будущего, а оставшийся рейтинг проверяется по более поздним результатам. Оценка помогает расставить приоритеты для ревью человеком, но не считается вероятностью покупки или автоматическим решением.
TL;DR
- -До выбора модели определите целевой результат, момент оценки и реальную ёмкость команды для ревью
- -Разделяйте ICP fit и текущий intent; каждый непустой критерий должен ссылаться на источник с отметкой времени
- -Проверяйте рейтинг на будущих результатах через precision@K, recall@K, lift@K, ROC AUC, покрытие источниками и сравнение с текущим процессом
- -Воспроизводимый синтетический fixture принимает 10 из 16 записей и отклоняет 6 до ранжирования; его метрики проверяют оценщик, а не LLM
- -Используйте score как подсказку, оставляйте содержательное ревью человеком, сокращайте персональные данные и изолируйте запись в CRM по принципу наименьших привилегий
Lead score легко выглядит убедительно. Модель возвращает 82, пишет аккуратное
объяснение, CRM поднимает карточку в очереди. Но само число ещё не доказывает, что лид
купит с большей вероятностью.
Поэтому начинать стоит не с вопроса «какую LLM взять?», а с другого:
Обгоняет ли этот рейтинг текущий процесс по более поздним результатам, не подсматривая в будущее и не маскируя отсутствующие данные?
Из этого вопроса следует архитектура. Модель предлагает структурированный score. Обычный код проверяет источники и арифметику. Time-based holdout измеряет качество рейтинга. Человек смотрит исходные сигналы до любого значимого действия.
Весь процесс на одной схеме
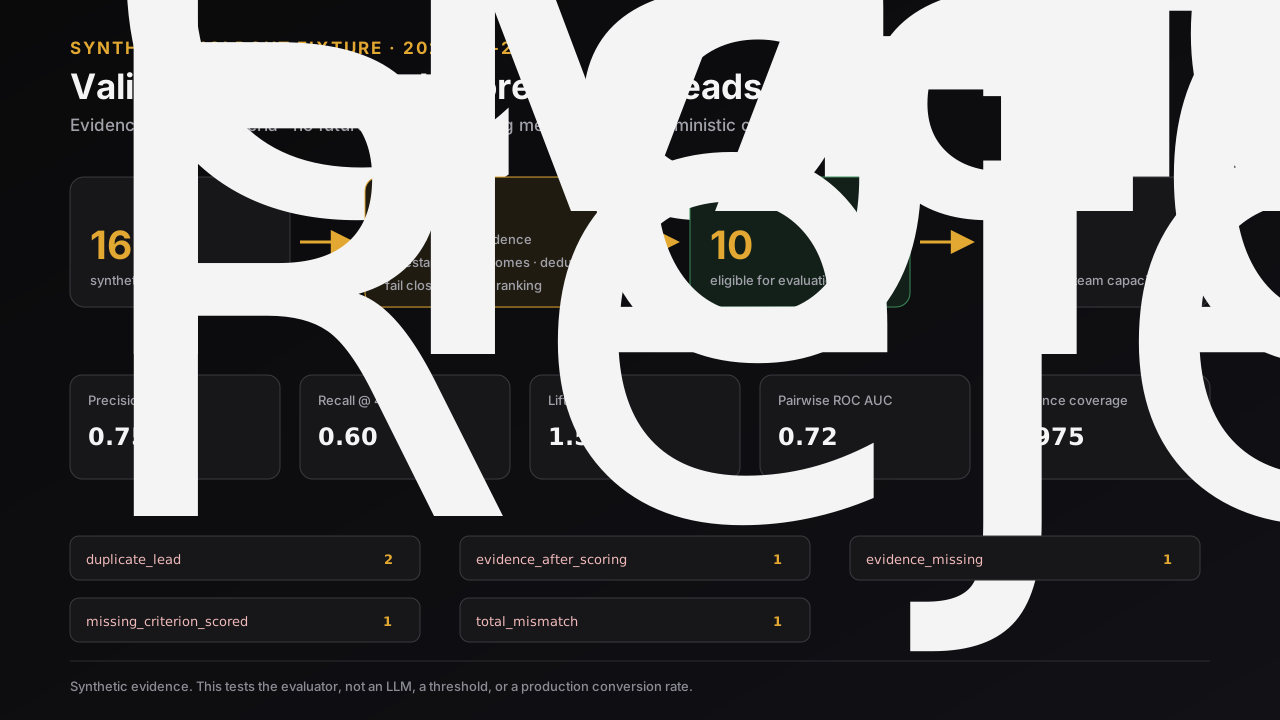
Схема построена из открытого TypeScript fixture. В нём только синтетические записи, нет внешних API, а поведение проверяют 25 тестов. В проверенном запуске поступило 16 кандидатов: 10 допущены к оценке, 6 отклонены до ранжирования.
Это проверка валидатора на конкретной выборке. Она ничего не говорит о качестве LLM, будущей production-конверсии или «правильном» пороге score.
Production-процесс выглядит так:
очищенные исходные данные
  → оценки fit и intent
  → детерминированная проверка
  → time-based holdout
  → очередь ревью человеком
  → контролируемая запись в CRM
Сначала решение, потом prompt
До реализации зафиксируйте четыре вещи.
1. Целевой результат
Слово «конвертировался» слишком расплывчато. Выберите одно событие, которое компания уже записывает одинаково: создана квалифицированная сделка, подписан оплаченный контракт или достигнута другая стабильная стадия. Вместе со значением храните время события.
Не меняйте определение в середине эксперимента. Если процесс продаж изменился, начните новую версию score и явно отметьте дату перехода.
2. Момент оценки
У каждого входного сигнала нужен observedAt, у каждого score — scoringAt. В расчёт
попадают только данные, которые существовали не позже scoringAt. Более поздний ответ,
изменение в CRM, событие в продукте или новость о компании относятся к будущему, даже
если во время ретроспективного анализа они уже лежат в базе.
Так появляется самый опасный самообман: модель кажется точной, потому что датасет случайно сообщает ей, чем закончилась история.
3. Ёмкость ревью
Если команда успевает разобрать 20 новых записей в день, оценивайте первые 20. Не начинайте с чужих границ вроде «Tier A — 75–100». Рабочая отсечка зависит от потока лидов, доступного времени, правил ответа и цены ложноположительного результата.
Ёмкость даёт числу K понятный бизнес-смысл. Тогда precision@K и recall@K напрямую
описывают реальную очередь.
4. Текущий процесс
Новая система соревнуется не с идеалом, а с текущим процессом: FIFO, rule-based score или описанная ручная сортировка. Сохраните исходный порядок на том же holdout-периоде. Если новый рейтинг не обгоняет baseline, ему рано управлять маршрутизацией.
Разделяйте fit и intent
ICP fit и покупательский intent отвечают на разные вопросы.
- Fit: относится ли компания и роль к рынку, для которого сделан продукт?
- Intent: есть ли сейчас наблюдаемые признаки, что компания изучает подходящую проблему или решение?
Хороший fit без текущего intent может попасть в долгосрочный план работы с компанией. Сильный intent при плохом fit требует быстрой ручной проверки. Один непрозрачный score стирает эту разницу.
Для каждой оси задайте небольшую шкалу:
| Ось | Критерий | Допустимый источник | Если данных нет |
|---|---|---|---|
| Fit | профиль компании | поле CRM или одобренный источник о компании | ноль + missing |
| Fit | роль покупателя | актуальная роль в CRM или проверенные данные формы | ноль + missing |
| Intent | явный запрос | точный фрагмент формы, чата или письма | ноль + missing |
| Intent | срок | датированное заявление или событие в продукте | ноль + missing |
Это контракт для примера, а не универсальная модель. Критерии и веса должны следовать из вашего ICP и проходить проверку на ваших результатах.
Не превращайте личный email-домен, географию или должность в безусловно негативный сигнал. Такие упрощения легко закрепляют смещение канала привлечения или сегмента, хотя выглядят как удобное правило.
Включите источники в схему ответа
Модель должна получать минимум данных для шкалы и возвращать критерии, а не свободный вердикт для отдела продаж. Пример кандидата:
{
  "leadId": "lead-042",
  "scoringAt": "2026-08-28T10:00:00Z",
  "fitScore": 31,
  "intentScore": 24,
  "totalScore": 55,
  "fitCriteria": [
    {
      "criterion": "company_profile",
      "score": 19,
      "maxScore": 30,
      "status": "observed",
      "evidenceSignalIds": ["signal-201"]
    }
  ],
  "intentCriteria": [
    {
      "criterion": "timing_signal",
      "score": 0,
      "maxScore": 20,
      "status": "missing",
      "evidenceSignalIds": []
    }
  ]
}
Используйте непрозрачный внутренний ID. Имя и email могут быть не нужны для вызова модели. Если достаточно короткого одобренного фрагмента или производного сигнала, не отправляйте полное личное сообщение.
Если провайдер умеет ограничивать ответ схемой, включите эту возможность. Актуальная
документация OpenAI Structured Outputs
описывает json_schema Structured Outputs и рекомендует его вместо старого JSON mode
на поддерживаемых моделях. Совпадение со схемой доказывает только корректную форму JSON,
но не существование источника и не обоснованность score.
Инструкция по извлечению может быть короткой:
Используй только предоставленные данные.
Не додумывай размер компании, полномочия, бюджет или timeline.
Отмечай отсутствующий критерий как missing с нулевым вкладом.
Для каждого observed criterion верни evidence IDs.
Верни критерии и оценки, но не решай, должен ли отдел продаж связаться с человеком.
Версионируйте модель и шкалу. Низкий temperature иногда уменьшает разброс, но не гарантирует воспроизводимость. Делайте повторные прогоны вместо веры в один параметр.
Проверяйте кандидата до ранжирования
Открытый fixture применяет fail-closed правила до расчёта метрик:
- Компоненты и total score не выходят за заявленные диапазоны.
- Суммы компонентов совпадают с total.
- У каждого observed criterion есть предоставленный исходный сигнал.
- Сигнал относится к тому же лиду и правильной оси score.
- Исходный сигнал появился до scoring, результат — после.
- Missing criterion даёт ноль, дубли записей отклоняются.
В синтетическом прогоне появились пять причин отказа:
| Проблема | Reason code |
|---|---|
| указанного сигнала нет | evidence_missing |
| сигнал появился после scoring | evidence_after_scoring |
| total не сходится | total_mismatch |
| missing criterion получил баллы | missing_criterion_scored |
| несколько кандидатов для одного лида | duplicate_lead |
Исходный код, тесты, манифест и точные команды доступны для независимого запуска. Код опубликован под MIT, документация и созданные артефакты — под CC BY 4.0.
Измеряйте рейтинг на более поздних результатах
Используйте временное разделение. На старых записях создайте или настройте шкалу, затем заморозьте её и просчитайте более поздний период. Для каждой записи берите только данные, существовавшие на момент scoring. Не считайте метрики, пока выбранный результат не успел созреть.
Для ограниченной очереди достаточно начать с шести показателей:
- Precision at K: доля первых K записей, достигшая выбранного результата.
- Recall at K: доля всех положительных результатов, попавшая в первые K.
- Lift at K: precision at K, поделённый на базовую частоту в holdout.
- ROC AUC: как часто положительная запись стоит выше отрицательной на всей принятой выборке.
- Evidence coverage: доля критериев, подтверждённых наблюдаемым сигналом.
- Rejection rate: доля кандидатов, не прошедшая проверку.
Fixture выдаёт precision@4 0.75, recall@4 0.60, lift@4 1.50, ROC AUC 0.72 и
evidence coverage 0.975. Это проверяемые значения для десяти принятых синтетических
записей, а не целевые показатели.
Всегда показывайте количество наблюдений рядом с долями. Сегмент с одним положительным результатом может дать красивый процент, но почти не дать информации. Смотрите качество по источникам и операционно важным сегментам, не публикуя узкие срезы, по которым можно узнать людей.
Ranking score — не вероятность
Число 80 не означает «80% вероятности покупки», если систему специально не
калибровали и не проверяли как вероятностную модель. Качество ранжирования и калибровка —
разные задачи.
Если прогнозу нужны вероятности, обучите слой калибровки на данных, которые не использовались для настройки исходного score. Затем проверяйте надёжность по сегментам и во времени. Статья ICML On Calibration of Modern Neural Networks хорошо объясняет разницу между точностью прогноза и калиброванной уверенностью, но её результаты не являются гарантией для данных отдела продаж.
Для приоритизации проще объяснить стабильный рейтинг и ограниченное ёмкостью K, чем псевдовероятность.
Ревью человеком должно быть настоящим
На экране ревью нужны:
- отдельные fit и intent scores;
- критерий, источник и время наблюдения;
- предупреждения о пропусках и reason codes валидатора;
- версии score, prompt, rubric и evidence;
- approve, reorder, defer и reject;
- причина правки как часть журнала аудита.
Если человек видит только score и кнопку «принять», это формальность, а не проверка. Исходные данные должны быть рядом, чтобы вывод можно было оспорить.
Не используйте score как единственное основание для решений с серьёзным влиянием на человека. Статья 22 GDPR регулирует полностью автоматизированные решения с правовыми или сопоставимо значимыми последствиями и предусматривает гарантии, включая участие человека в охваченных случаях. Сверяйтесь с текстом Regulation (EU) 2016/679 и профильным юристом. Применимость статьи 22 зависит от конкретного процесса и его последствий. Нельзя заранее считать обычную приоритизацию продаж ни автоматически охваченной, ни автоматически исключённой: профилирование всё равно требует законного, прозрачного и соразмерного обращения с данными.
Сокращайте данные и изолируйте побочные действия
В карточках лидов встречаются персональные данные, личные сообщения, коммерческий контекст и секреты, случайно вставленные в форму. До вызова модели:
- зафиксируйте цель и правовое основание;
- удалите поля, не нужные для шкалы;
- отредактируйте секреты и лишние идентификаторы;
- задайте сроки хранения входов, ответов, источников и журналов аудита;
- ограничьте доступ по роли и tenant;
- проверьте хранение, обучение и региональную обработку у провайдера;
- предусмотрите подходящий способ исправления данных или возражения.
OWASP в разделе Sensitive Information Disclosure относит PII, коммерческие данные и учётные данные к информации, которую нужно защищать, и рекомендует очищать данные до обработки моделью. Раздел Improper Output Handling также напоминает: ответ модели нужно считать недоверенным вводом для следующих систем.
Сервис scoring не должен владеть широкими правами в CRM. Запись вынесите в отдельный серверный компонент, который принимает только проверенные поля и работает от имени учётной записи с минимальными правами. В OWASP Excessive Agency рекомендуется сокращать функциональность, разрешения и автономность, а для действий с серьёзными последствиями сохранять подтверждение человеком.
Храните в CRM происхождение score, а не только число
Одного изменяемого поля ai_score недостаточно. Нужны данные, по которым решение можно
восстановить:
ai_score_total
ai_score_fit
ai_score_intent
ai_score_version
ai_scored_at
ai_evidence_coverage
ai_validation_status
ai_review_status
ai_reviewed_at
Лучше хранить компактные reason codes и ссылки на источники, а не копировать полные личные сообщения в каждую карточку. Актуальная документация HubSpot CRM properties описывает создание и обновление пользовательских полей. Для другой CRM сверяйтесь с её текущим API и моделью разрешений.
Запись в CRM должна быть идемпотентной. Подойдёт ключ вроде
leadId + scoreVersion + scoringAt: повторный запрос обновляет или возвращает ту же
запись, а не создаёт несколько конкурирующих scores.
Что мониторить после запуска
Сначала включите shadow mode: считайте scores и собирайте обратную связь ревьюеров, но не отдавайте модели маршрутизацию в production. Затем следите за:
- доля отказов валидатора по причинам;
- пропуски и evidence coverage по источникам;
- precision, recall, lift и AUC после созревания outcomes;
- доля правок и их причины;
- объёмом очереди и response SLA;
- drift по важным для бизнеса сегментам;
- версиями модели, prompt, шкалы, обогащения и схемы CRM.
NIST AI Risk Management Framework рекомендует тестировать AI-системы до запуска и регулярно во время работы, документируя качество и неопределённость. AI RMF 1.0 — добровольный стандарт, но его подход «измерять и наблюдать» здесь уместен.
Чеклист внедрения
- Определите один результат и его время.
- Зафиксируйте версию score и шкалу fit/intent.
- Соберите point-in-time данные со стабильными ID.
- Уберите лишние персональные данные до вызова модели.
- Требуйте структурированные критерии со ссылками на источники.
- Отклоняйте пропуски, будущие данные, дубли и несогласованные записи обычным кодом.
- Сравните time-based holdout с текущим baseline.
- Выберите K по ёмкости ревью, а не по чужому диапазону score.
- Покажите ревьюеру источники и историю версий.
- Изолируйте идемпотентную запись в CRM за минимальными правами.
- Запустите shadow mode и записывайте правки.
- Переключайте маршрутизацию только когда это подтверждают данные.
LLM полезна, когда важные сигналы спрятаны в неструктурированном тексте. Если входы уже представлены чистыми полями и событиями, начните с прозрачных правил или обычной статистической модели. Требования к проверке, holdout, приватности и ревью от этого не исчезают.
Lead score — это сигнал для маршрутизации, а не проверенное описание клиента. Перед презентацией используйте сценарий демо продукта, чтобы отделить discovery с источником от гипотез и отрепетировать только то состояние продукта, которое действительно можно показать.
Для подготовки критериев пригодится гайд по ideal customer profile, а для границы полномочий — паттерны human-in-the-loop.